Indexen in de console
Het concept achter kennis staat in Kennis.
In het segment Indexen van Kennis maak je een index, kies je haar collecties en pipeline, en volg je wat er is verwerkt. Een index verwerkt bronnen uit een of meer collecties tot doorzoekbare fragmenten en embeddings. Meerdere indexen kunnen dezelfde collectie gebruiken met verschillende verwerkingsinstellingen.
Je hebt een beheerdersaccount van de organisatie nodig, en de capability knowledge moet in het
plafond van de organisatie aanstaan. Hetzelfde doe je met een sleutel in
Kennis via de API.
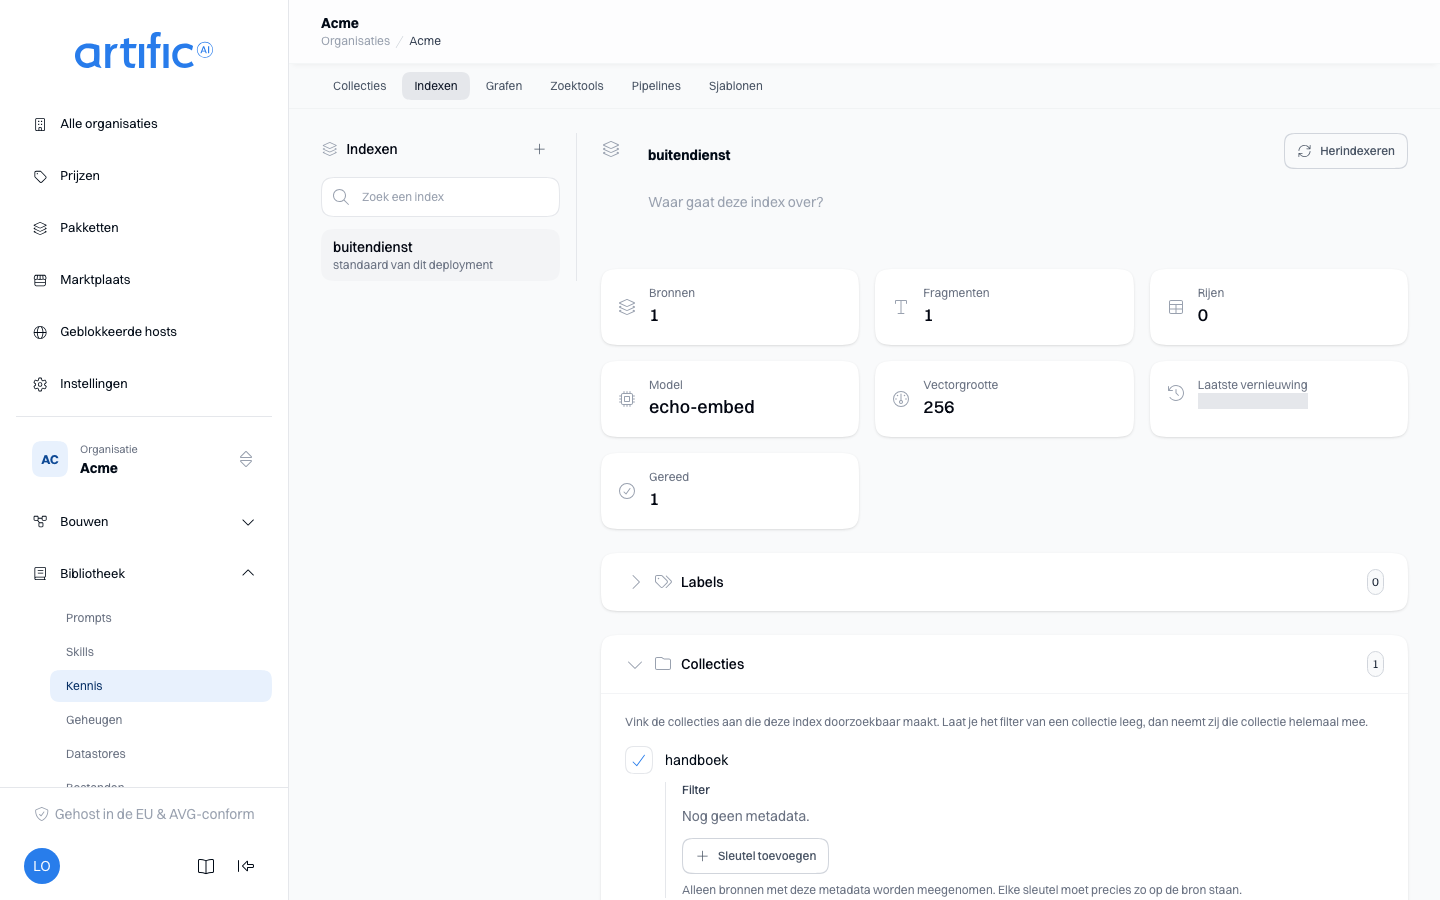
Links staat de lijst met indexen, rechts de index die je koos. Zoek erboven om de lijst te versmallen, en kies de plus om er een te maken. Zolang je niets hebt gekozen staat er rechts wat je kunt doen; het adres verandert niet vanzelf.
Een index aanmaken
Kies de plus boven de lijst, vul een unieke Naam en een Omschrijving in en stel daarna het volgende in. Alleen de collectiekeuze is verplicht.
| Veld | Wat je kiest |
|---|---|
| Collecties | de collecties die deze index doorzoekbaar maakt; vink er meerdere aan |
| Embedding-model | leeg laten betekent het standaardmodel van deze installatie |
| Ingest-pipeline | leeg laten betekent de standaard voor deze vorm; anders een ingebouwde template of een eigen pipeline |
Selecteer bij een eigen pipeline ook de Versie. De index blijft die versie gebruiken totdat je een andere kiest.
Na het opslaan opent de index. Bronverwerking gebeurt afzonderlijk nadat de configuratie is opgeslagen.
Naam en omschrijving wijzigen
Naam en omschrijving bewerk je waar ze staan: klik erin en typ. Zodra er iets is gewijzigd verschijnt een balk met Annuleren en Opslaan. Eén Opslaan schrijft alles wat je op dit scherm hebt aangepast, ook de collecties en hun filters.
Wat deze index bevat
De kaarten bovenaan komen uit één uitlezing en zeggen wat de index nú bevat.
| Kaart | Wat het getal is |
|---|---|
| Bronnen | alle bronnen die deze index heeft binnengetrokken, ongeacht hun status |
| Fragmenten | de fragmenten van de bronnen die Gereed zijn |
| Rijen | de rijen in de gestructureerde bronnen die deze index binnentrekt |
| Model en Vectorgrootte | het embedding-model dat geldt, en de breedte van de vectoren |
| Laatste vernieuwing | wanneer er voor het laatst iets is verwerkt |
Daaronder staat Gereed altijd. Bezig en Aandacht nodig verschijnen alleen als ze niet nul zijn; beweeg over Bezig om te zien hoeveel er in de wachtrij staan en hoeveel er worden verwerkt. Loopt er een herindexering, dan staat er een balk boven de secties met hoeveel bronnen er al verwerkt zijn; die telt vanzelf door en verdwijnt als de run klaar is.
Collecties en hun filter
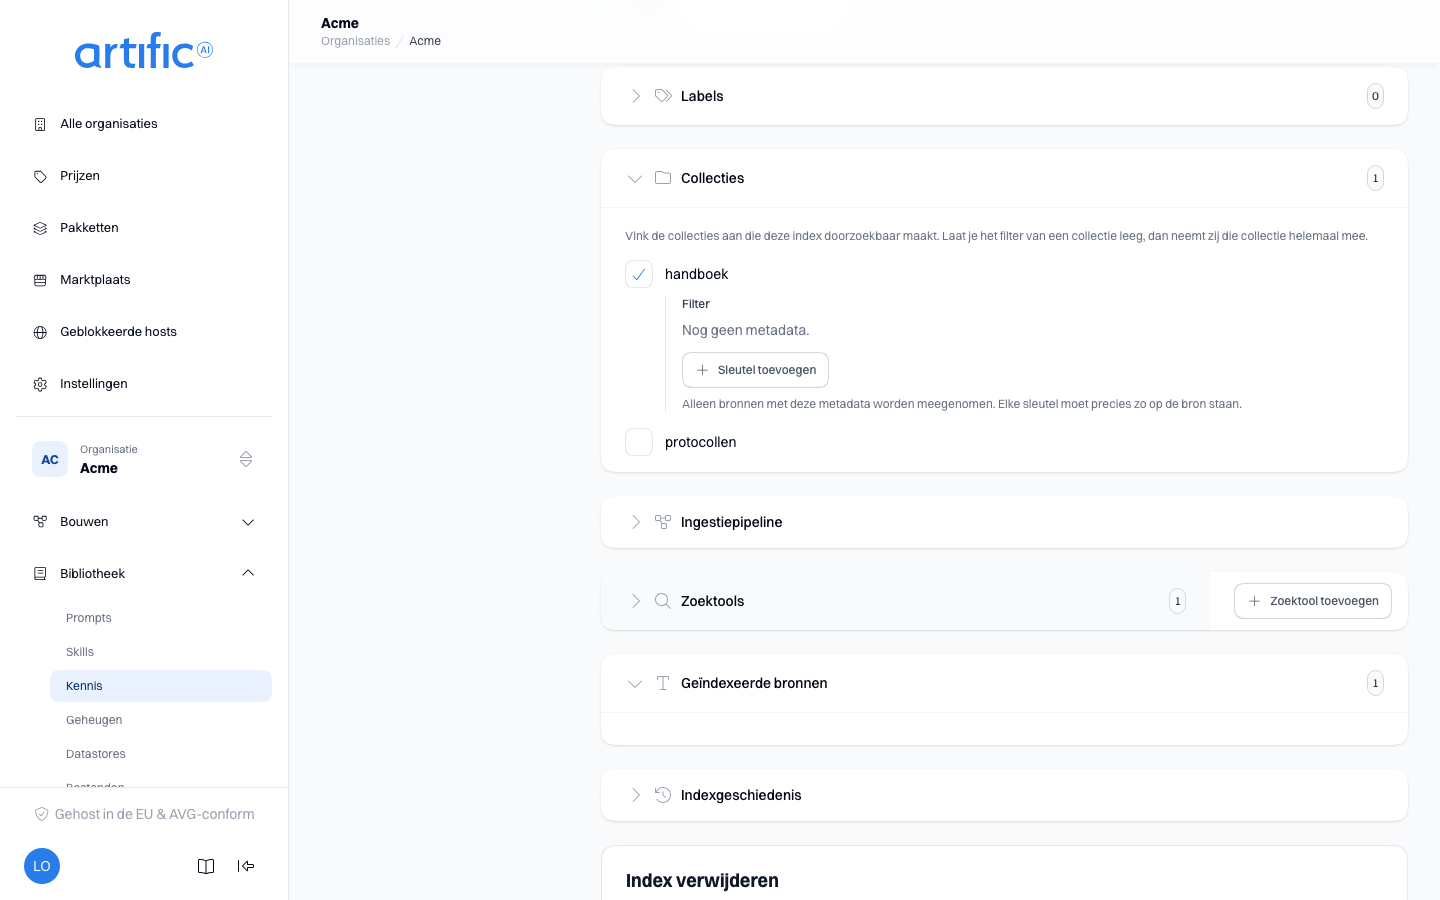
Collecties is de eerste sectie. Vink de collecties aan die deze index doorzoekbaar maakt. Onder een aangevinkte collectie staat Filter: sleutels en waarden die op de metadata van een bron moeten staan voordat deze index haar binnentrekt. Laat je het filter leeg, dan neemt de index de hele collectie mee.
Een filter is een precieze vergelijking: afdeling met waarde zorg neemt alleen bronnen mee
waar die sleutel met die waarde op staat. Metadata van een bron pas je aan in de
collectie; verandert die, dan bepaalt Core opnieuw in welke
indexen de bron thuishoort.
Ingestiepipeline en het model
Ingestiepipeline bevat het Embedding-model en, onder Stappen, de tekening van wat deze index met een bron doet. Beide horen bij elkaar: een wijziging in een van de twee vraagt om herindexeren. Ontbreekt de stap Tabular extract, dan staat er een waarschuwing bij: tabellen in bestanden worden dan niet als rijen opgeslagen. Verwerkingsstappen bewerken opent de editor; zie Pipelines.
Zoektools op deze index
Zoektools toont de zoektools waarvan de pipeline deze index in een bronblok noemt; elke naam opent de zoektool. Een lege sectie betekent dat geen zoektool deze index doorzoekt. Een zoektool maak je in het segment Zoektools, waar je deze index als bron kiest.
Geïndexeerde bronnen en de geschiedenis
Geïndexeerde bronnen toont de status en het aantal fragmenten per bron, bij naam. Zoek erboven op titel of beperk de lijst tot één status. Een regel brengt je naar de collectie waar de bron staat. Deze index heeft nog niets verwerkt betekent dat er nog geen inhoud is verwerkt of dat de verwerking nog loopt.
Indexgeschiedenis toont herindexeringen. Voortgang toont aantallen afgeronde en mislukte bronnen. Aanleiding is Volledig opnieuw of Mislukte opnieuw, naar wat je koos. Automatische verwerking van nieuwe bronnen staat onder Geïndexeerde bronnen, zonder aparte run.
Herindexeren na wijzigingen
Herindexeren verwerkt elke bron die de index binnentrekt opnieuw, en verwijdert de verwerkte inhoud van bronnen die ze niet meer binnentrekt. Gebruik het in deze gevallen:
| Wat je deed | Wat er gebeurt totdat je herindexeert |
|---|---|
| het Embedding-model of de Ingestiepipeline gewijzigd | Een waarschuwing boven het scherm, met de knop Herindexeren erin. Zoekopdrachten blijven de eerder verwerkte inhoud gebruiken. |
| een collectie aangevinkt waar al bronnen in zaten, of een filter van een collectie verruimd | De bronnen die er nu bij horen ontbreken onder Geïndexeerde bronnen en in zoekopdrachten. |
| een collectie uitgevinkt, of een filter van een collectie vernauwd | Niets wacht: vanaf de volgende zoekopdracht komen de bronnen die er niet meer bij horen niet meer terug. Geïndexeerde bronnen en de kaarten bovenaan tonen ze nog totdat de herindexering hun verwerkte inhoud verwijdert. |
| een bron toegevoegd vóórdat deze index haar collectie koos | De index verwerkt deze bron niet. |
Kies Herindexeren rechtsboven om de verwerking te starten. Nieuwe bronnen in een al gekoppelde collectie worden automatisch verwerkt; daarvoor is deze actie niet nodig. Er loopt één herindexering tegelijk. Een herindexering die alleen nog wacht op bronnen die bij de maandelijkse kostenlimiet worden vastgehouden, houdt een volledige herindexering niet tegen: start je die, dan eindigt de wachtende run, die daarna als Afgebroken in Indexgeschiedenis staat. Mislukte bronnen opnieuw proberen vervangt haar niet, en een herindexering die je net startte weigert een tweede totdat ze haar bronnen heeft opgepakt.
Een herindexering wordt in rekening gebracht. Ze laat het embedding-model, en eventuele modelstappen van de pipeline, opnieuw over elke bron lopen, ook als er sinds de vorige keer niets is veranderd, en dat verbruik telt mee voor je maandlimiet. Mislukte opnieuw verwerkt, en berekent, alleen de bronnen die mislukt waren. Werk dat Core uit zichzelf herhaalt betaal je niet dubbel: wordt de verwerking van een bron aan de kant van Core onderbroken en opnieuw gestart, dan kosten de herhaalde aanroepen je niets.
Sla je een wijziging in het model, de pipeline of de collecties op terwijl er een herindexering loopt, dan is die run achterhaald. Core beëindigt hem, en Indexgeschiedenis toont hem als Afgebroken. Start een nieuwe herindexering voor de index zoals die nu is; wordt die geweigerd omdat de oude run nog niet beëindigd is, probeer het dan iets later opnieuw.
Een index verwijderen
Gebruik de verwijderknop onderaan en typ de indexnaam ter bevestiging. De index en de verwerkte inhoud worden verwijderd. Collecties en bronnen blijven beschikbaar voor een andere index.
De geheugenrecords die in de index zijn opgeslagen, gaan mee. Ze worden in dezelfde stap als de index verwijderd, niet later door een achtergrondtaak, en er is geen prullenbak om ze uit terug te zetten: zodra het verwijderen gelukt is, vindt lezen of zoeken die records niet meer.
Core weigert het verwijderen met een 409 die de oorzaak noemt zolang een API-sleutel geheugen uit
de index inspuit, of zolang geheugenextractie voor de index aanstaat: haal de index uit de sleutel
weg, of zet de extractie eerst uit. De bevestiging blijft open en toont wat in de weg zit, de
sleutels als links.
Een zoektool die naar de index verwijst houdt het verwijderen niet tegen. Werk hem bij voordat je de index verwijdert; anders blijft hij bestaan, maar vindt hij niets meer.
Labels
Gebruik Labels op het indexscherm of in het aanmaakformulier om indexen in te delen.
De toegangscontrole heeft twee onderdelen:
- Regels over Kennisindexen bepalen of een persoon de index mag gebruiken.
- Regels over Kennisbronnen bepalen welke documenten die persoon binnen de index mag terugvinden.
Schrijf deze regels in de policy van een sleutel (Regels over een persoon). Zie ook Bouwen voor personen.
Lege lijsten en toegangsbeperkingen
Staat er links niets, dan heeft deze organisatie geen indexen.
Is kennis uitgeschakeld, dan staat Kennisbronnen indexeren en doorzoeken uit in het plafond van de organisatie. De beheerder van de organisatie erboven zet het aan bij Toegestane capabilities op Instellingen; voor een organisatie zonder bovenliggende organisatie doet je operator dat.